
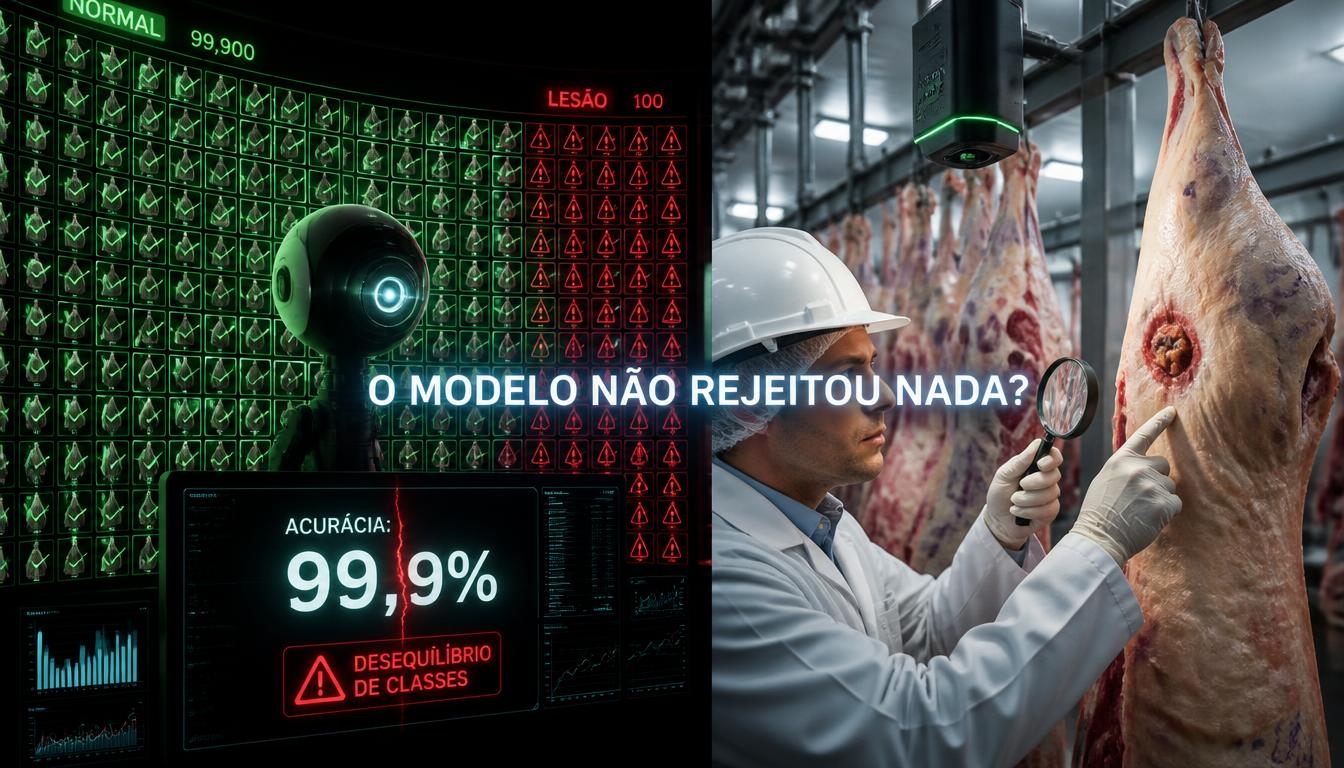
Imagine um sistema de visão computacional treinado com 100 mil imagens de carcaças bovinas. Em 99.900 delas não há nada de grave. Nas 100 restantes aparecem lesões compatíveis com tuberculose, cisticercose ou abscessos. O modelo fica pronto, é testado e alcança 99,9% de acerto. Parece excelente. Até que alguém percebe uma possibilidade inquietante: um modelo que respondesse “carcaça normal” para todas as imagens, sem olhar nada, teria exatamente o mesmo resultado.
Esse é o problema do desequilíbrio de classes, um dos conceitos menos conhecidos e mais importantes para quem vai avaliar, comprar ou fiscalizar ferramentas de inteligência artificial na inspeção. Ele explica por que a IA costuma tropeçar justamente no que mais importa: o achado raro.
O conceito, primeiro para qualquer pessoa
Um algoritmo de aprendizado de máquina aprende por exemplos. Se você mostra muitos exemplos de uma coisa e poucos de outra, ele fica muito bom na primeira e fraco na segunda. É como um estudante que fez mil exercícios de soma e cinco de divisão. Na prova, ele vai bem na média e mal justamente na questão difícil.
Na inspeção de produtos de origem animal, as condições que justificam condenar uma carcaça ou um órgão são, felizmente, minoria. A maior parte do que passa pela linha está apta para consumo. O efeito colateral é que os dados disponíveis para treinar uma IA são, por natureza, desequilibrados: sobram exemplos do normal e faltam exemplos do que precisa ser encontrado.
Agora, o detalhe técnico
Na literatura de aprendizado de máquina, o tema é tratado como “aprendizado com dados desbalanceados”. Uma revisão clássica de Haibo He e Edwardo Garcia, publicada em 2009 na IEEE Transactions on Knowledge and Data Engineering, descreve por que algoritmos treinados nessas condições tendem a favorecer a classe majoritária. Ela também reúne as estratégias para lidar com isso: reamostragem dos dados, geração de exemplos sintéticos e ajuste do custo dos erros, entre outras.
O desequilíbrio também afeta a forma de medir o desempenho. A acurácia, a porcentagem total de acertos, é dominada pela classe mais comum e pode esconder um modelo que quase nunca encontra o que é raro. Por isso, avaliações sérias informam a sensibilidade, isto é, a proporção dos casos realmente doentes que o modelo detectou. Informam também a especificidade e o valor preditivo positivo: dos alertas que o modelo deu, quantos estavam certos. Um estudo de Takaya Saito e Marc Rehmsmeier (PLoS ONE, 2015) mostrou que, em dados desbalanceados, as curvas de precisão e sensibilidade são mais informativas do que a tradicional curva ROC, que pode passar uma impressão otimista demais.
Há ainda um segundo problema, vizinho do primeiro: o viés de representatividade. Mesmo com classes equilibradas, o modelo só conhece o mundo que viu. Se foi treinado com imagens de uma raça, de um sistema de criação, de uma iluminação de linha ou de uma velocidade de abate, pode falhar quando qualquer uma dessas condições muda. O algoritmo vê o que foi treinado para ver.
Como isso aparece na prática no Brasil
No Brasil, a decisão de liberar, condenar ou dar destino condicional a uma carcaça é tomada no âmbito da inspeção oficial, segundo os critérios do RIISPOA (Decreto nº 9.013/2017). Qualquer ferramenta de IA que venha a apoiar essa decisão terá de lidar com três realidades:
- Doenças de baixa prevalência: em várias regiões, lesões de certas doenças são raras na linha de abate. São justamente as que a vigilância mais precisa captar, porque a inspeção post mortem é uma fonte de dados para os programas de controle e erradicação.
- Diversidade do rebanho: raças zebuínas e taurinas, criação a pasto ou confinamento, animais de diferentes idades. Um modelo treinado no exterior, ou em uma única planta, pode não representar essa variedade.
- Diversidade de plantas: iluminação, câmeras, velocidade e posição da carcaça mudam de um estabelecimento para outro.
O debate regulatório internacional já incorporou essas preocupações. O Regulamento Europeu de IA (Regulamento (UE) 2024/1689, o AI Act) exige, no artigo 10, que os dados de treino, validação e teste de sistemas de alto risco sejam relevantes, suficientemente representativos e, na medida do possível, livres de erros e completos. Os princípios de Boas Práticas de Aprendizado de Máquina publicados em 2021 pela FDA (EUA), pela Health Canada e pela MHRA (Reino Unido) para dispositivos médicos seguem a mesma linha. Eles pedem que os dados reflitam a população em que a ferramenta será usada e que o desempenho seja avaliado em condições clinicamente relevantes. São referências de outros setores, mas a lógica vale integralmente para a inspeção.
Erros comuns de entendimento
- “99% de acurácia é sinônimo de ferramenta pronta.” Não é. Em dados desbalanceados, a acurácia pode ser alta mesmo com sensibilidade baixa para o achado raro. Pergunte sempre pela sensibilidade, pelo valor preditivo positivo e pelo número de casos positivos usados no teste.
- “Basta ter muitos dados.” Cem mil imagens com cem casos positivos ainda são cem casos positivos. O que conta é quantos exemplos existem da condição que se quer detectar, e de quantas origens diferentes.
- “Dados sintéticos resolvem tudo.” Gerar exemplos artificiais ajuda no treino, mas não substitui a validação com casos reais, em plantas diferentes daquela em que o modelo foi desenvolvido.
- “Se o modelo funcionou no frigorífico A, vai funcionar no B.” Só a validação externa responde a isso. E, como a realidade muda com o tempo, o desempenho precisa ser monitorado continuamente.
O que perguntar antes de confiar
Para o profissional de inspeção, o RT ou o gestor de qualidade, o conceito vira um roteiro de perguntas ao fornecedor:
- Quantos exemplos de cada condição relevante havia no treino e no teste?
- Qual a sensibilidade para cada lesão, separadamente, e não apenas a média geral?
- O teste foi feito em plantas, raças e condições diferentes das usadas no treino?
- Quantos falsos negativos ocorreram, e quais eram?
- Como o desempenho será acompanhado depois da implantação?
Se o fornecedor só tem a acurácia global para mostrar, ainda não há evidência suficiente para a ferramenta apoiar uma decisão sanitária.
Em resumo
- A IA aprende com exemplos; quando o que importa é raro, ela tende a aprender mal justamente isso.
- Acurácia alta não basta em dados desbalanceados: sensibilidade e valor preditivo positivo contam mais.
- Representatividade é tão importante quanto quantidade. O modelo precisa ter visto o rebanho, a planta e as condições brasileiras.
- Regras e diretrizes internacionais já exigem dados representativos e avaliação em condições reais.
- O julgamento do médico-veterinário oficial continua indispensável, sobretudo para o caso raro que o algoritmo quase nunca viu.
Referências
- He H, Garcia EA (2009). Learning from Imbalanced Data. IEEE Transactions on Knowledge and Data Engineering, 21(9), 1263–1284. DOI: 10.1109/TKDE.2008.239 — https://doi.org/10.1109/TKDE.2008.239
- Saito T, Rehmsmeier M (2015). The Precision-Recall Plot Is More Informative than the ROC Plot When Evaluating Binary Classifiers on Imbalanced Datasets. PLoS ONE, 10(3), e0118432. DOI: 10.1371/journal.pone.0118432 — https://doi.org/10.1371/journal.pone.0118432
- União Europeia. Regulamento (UE) 2024/1689 (Regulamento da Inteligência Artificial), artigo 10 — https://eur-lex.europa.eu/eli/reg/2024/1689/oj
- FDA, Health Canada, MHRA. Good Machine Learning Practice for Medical Device Development: Guiding Principles (2021) — https://www.fda.gov/medical-devices/software-medical-device-samd/good-machine-learning-practice-medical-device-development-guiding-principles
- Brasil. Decreto nº 9.013, de 29 de março de 2017 (RIISPOA) — https://www.planalto.gov.br/ccivil_03/_ato2015-2018/2017/decreto/d9013.htm
Leia também no Além do Carimbo: “99% de acerto, metade dos alertas errados: a conta de prevalência que decide se um algoritmo serve para a inspeção” e “O algoritmo também envelhece: o que é a deriva de modelo e por que uma IA validada na inspeção precisa de vigilância contínua”.


Deixe um comentário