
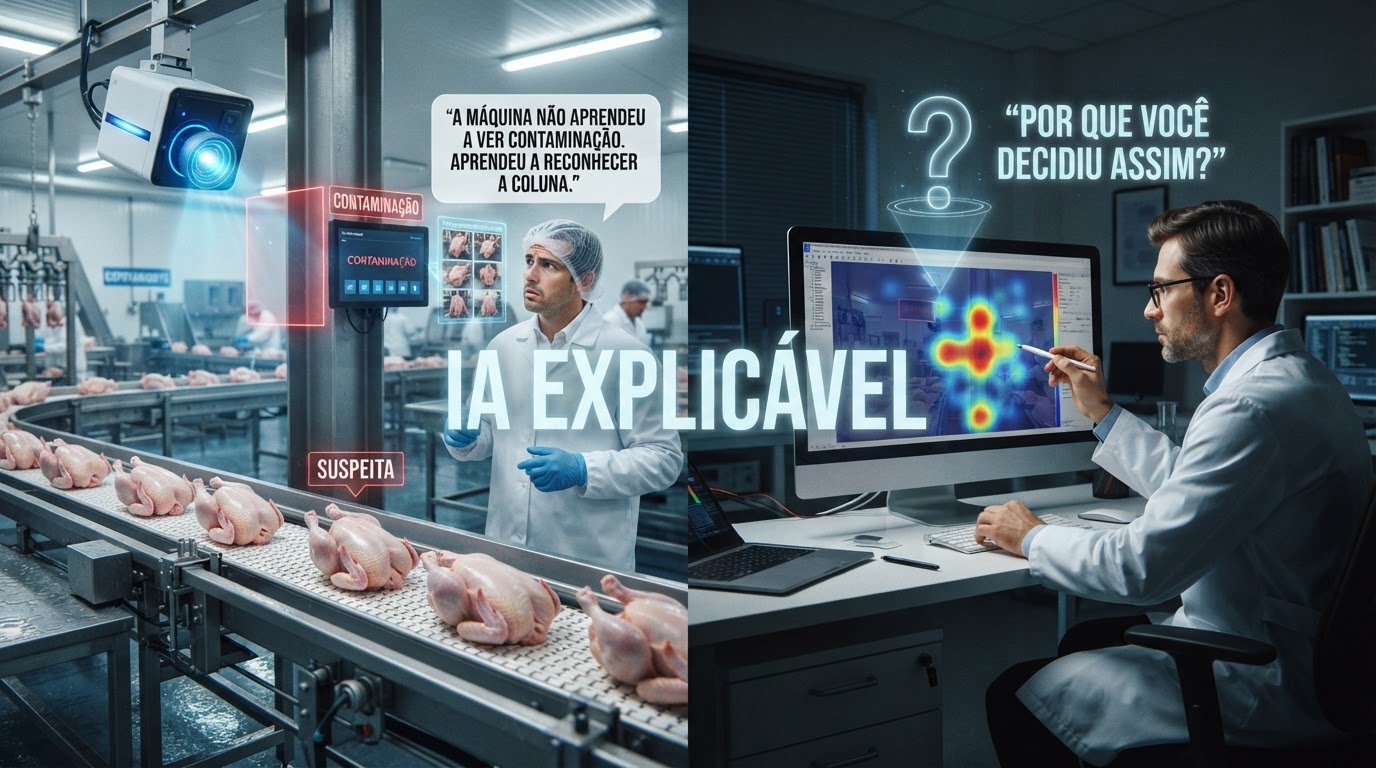
Imagine uma câmera instalada na linha de abate que separa carcaças com e sem contaminação visível. Nos testes do fornecedor, o desempenho é excelente. Na planta, ela começa a marcar como suspeitas quase todas as carcaças que passam perto de uma determinada coluna da sala. Ninguém entende por quê, até alguém descobrir que, nas imagens usadas para treinar o sistema, as carcaças contaminadas tinham sido fotografadas, por acaso, justamente naquele ponto da linha, com aquela iluminação. A máquina não aprendeu a ver contaminação. Aprendeu a reconhecer a coluna.
A cena é hipotética, mas o problema é real e documentado na ciência da computação. É por isso que existe um campo chamado IA explicável, e é por isso que quem trabalha com inspeção precisa saber fazer uma pergunta simples a qualquer algoritmo: por que você decidiu assim?
O conceito, primeiro para qualquer pessoa
Muitos sistemas de inteligência artificial modernos, especialmente os de aprendizado profundo usados em visão computacional, são chamados de “caixas-pretas”. Eles recebem uma imagem e devolvem uma resposta, como “contaminado” ou “não contaminado”, mas o caminho entre a entrada e a saída passa por milhões de parâmetros ajustados durante o treino, que nenhuma pessoa consegue ler diretamente.
IA explicável, ou XAI (do inglês explainable artificial intelligence), é o conjunto de métodos que tenta abrir essa caixa: mostrar quais partes da imagem pesaram mais na decisão, quais variáveis influenciaram um alerta, ou em que situações o modelo tende a errar. Não é uma garantia de acerto. É uma ferramenta para que um ser humano possa conferir se o raciocínio da máquina faz sentido.
Agora, o detalhe técnico
Em visão computacional, uma das formas mais conhecidas de explicação são os mapas de calor, ou mapas de saliência. Técnicas como a Grad-CAM, descrita por Selvaraju e colaboradores em 2017, colorem a imagem original para indicar as regiões que mais contribuíram para a classificação. Se o sistema diz “lesão” e o mapa de calor acende sobre a lesão, ótimo. Se acende sobre o gancho, a etiqueta ou o fundo, há um problema.
Outra família de métodos, como o LIME, proposto por Ribeiro, Singh e Guestrin em 2016, testa a decisão do modelo alterando partes da entrada e observando o que muda. No artigo original, os autores treinaram de propósito um classificador para separar fotos de lobos e de cães husky usando um conjunto de imagens em que os lobos apareciam com neve ao fundo. O modelo “acertava”, mas a explicação mostrou que ele olhava para a neve, não para o animal. O experimento foi desenhado para verificar se as pessoas conseguiriam perceber o erro com ajuda da explicação.
O fenômeno ganhou nome: efeito “Clever Hans”, em referência a um cavalo do início do século XX que parecia fazer contas, mas na verdade reagia a sinais involuntários de quem o observava. Em 2019, Lapuschkin e colaboradores mostraram, na revista Nature Communications, um classificador que identificava fotos de cavalos com base, em parte, em uma marca de copyright presente em muitas dessas imagens. Na medicina, Zech e colaboradores (2018) relataram que um modelo para detectar pneumonia em radiografias conseguia identificar o hospital de origem das imagens, o que poderia levar o algoritmo a usar pistas que nada têm a ver com a doença.
O algoritmo vê o que foi treinado para ver, inclusive aquilo que ninguém pretendia ensinar.
Como isso aparece na prática no Brasil
No Brasil, o julgamento e a destinação de carcaças e produtos são atos do serviço oficial de inspeção, previstos no Regulamento da Inspeção Industrial e Sanitária de Produtos de Origem Animal (RIISPOA, Decreto nº 9.013/2017). Um sistema de IA pode apoiar o trabalho, mas a responsabilidade técnica e legal pela decisão continua sendo humana. E uma pessoa só consegue assumir responsabilidade por uma decisão que é capaz de entender e contestar.
No plano regulatório da IA, o Projeto de Lei nº 2.338/2023, que propõe um marco legal para a inteligência artificial no país, foi aprovado pelo Senado Federal em dezembro de 2024 e enviado à Câmara dos Deputados. Na União Europeia, o Regulamento (UE) 2024/1689, conhecido como AI Act, exige que sistemas classificados como de alto risco sejam suficientemente transparentes para que os usuários interpretem seus resultados (artigo 13) e que sejam projetados para permitir supervisão humana efetiva (artigo 14). Se uma ferramenta específica de inspeção se enquadra como alto risco depende da análise de cada caso. Nos Estados Unidos, o Marco de Gestão de Riscos de IA do NIST (AI RMF 1.0, de 2023) lista “explicável e interpretável” entre as características de uma IA confiável.
Para quem trabalha numa planta ou num serviço de inspeção, isso se traduz em perguntas concretas ao fornecedor de uma ferramenta:
- O sistema mostra por que classificou cada caso, por exemplo com mapa de calor ou indicação da região da imagem?
- Em que condições ele foi treinado: iluminação, velocidade de linha, espécie, tipo de lesão?
- Quais são os erros típicos, e os falsos negativos foram analisados um a um?
- Alguém revisou explicações de uma amostra de casos para ver se o modelo olha para o lugar certo?
- O que acontece quando o sistema e o inspetor discordam, e quem registra isso?
Erros comuns de entendimento
O primeiro erro é achar que explicação é sinônimo de acerto. Um mapa de calor bonito pode estar apontando a região certa por acaso, e métodos de explicação também têm limitações e podem ser instáveis. A explicação ajuda a desconfiar com critério; não substitui a validação com dados da própria planta.
O segundo é pensar que, se o modelo é muito preciso, explicação é luxo. O caso dos lobos e da neve mostra o contrário: um modelo pode ter ótimo desempenho no conjunto de teste justamente porque aprendeu um atalho que existe nos dados de teste, mas não no mundo real. Quando a câmera vai para outra planta, com outro fundo e outra luz, o atalho desaparece, e o desempenho junto com ele.
O terceiro é acreditar que IA explicável é assunto só para cientistas de dados. Quem conhece a anatomia da carcaça, as lesões e a rotina da linha é exatamente quem está mais bem posicionado para perceber quando a explicação não faz sentido. O inspetor que olha para um mapa de calor aceso sobre o gancho sabe, em um segundo, que algo está errado.
Lente IA: o que muda para o profissional
A IA explicável não transforma o inspetor em programador. Ela devolve a ele um papel que a caixa-preta tira: o de examinar o raciocínio, não só o resultado. Isso exige letramento em IA, ou seja, saber o que é treino, validação, falso negativo e viés, e saber exigir, no contrato e no procedimento, que a ferramenta mostre seus motivos. Também ajuda a combater o viés de automação, a tendência humana de confiar demais no que a máquina diz, porque obriga a conferir antes de aceitar.
Em resumo
- Muitos modelos de IA são caixas-pretas: dão a resposta, mas não o motivo.
- IA explicável reúne métodos que mostram o que pesou na decisão, como os mapas de calor.
- Modelos podem acertar pelos motivos errados, aprendendo atalhos como fundo, etiqueta ou iluminação.
- Explicação não é garantia de acerto, mas é condição para que um humano possa supervisionar e assumir a decisão.
- Antes de adotar uma ferramenta, pergunte ao fornecedor como ela explica suas decisões e quem revisou essas explicações.
Leia também no Além do Carimbo: “Quem assina quando a câmera vê? IA, julgamento do inspetor e a responsabilidade que nenhum algoritmo carrega” e “Antes de assinar o contrato: 10 perguntas que o RT deve fazer a quem vende inteligência artificial”.
Referências
- Ribeiro MT, Singh S, Guestrin C (2016). “Why Should I Trust You?”: Explaining the Predictions of Any Classifier. Proceedings of the 22nd ACM SIGKDD. DOI 10.1145/2939672.2939778 — https://doi.org/10.1145/2939672.2939778
- Selvaraju RR, Cogswell M, Das A et al. (2017). Grad-CAM: Visual Explanations from Deep Networks via Gradient-Based Localization. IEEE ICCV. DOI 10.1109/ICCV.2017.74 — https://doi.org/10.1109/ICCV.2017.74
- Lapuschkin S, Wäldchen S, Binder A et al. (2019). Unmasking Clever Hans predictors and assessing what machines really learn. Nature Communications 10: 1096. DOI 10.1038/s41467-019-08987-4 — https://doi.org/10.1038/s41467-019-08987-4
- Zech JR, Badgeley MA, Liu M et al. (2018). Variable generalization performance of a deep learning model to detect pneumonia in chest radiographs: a cross-sectional study. PLOS Medicine 15(11): e1002683. DOI 10.1371/journal.pmed.1002683 — https://doi.org/10.1371/journal.pmed.1002683
- União Europeia. Regulamento (UE) 2024/1689 (Regulamento da Inteligência Artificial) — https://eur-lex.europa.eu/eli/reg/2024/1689/oj
- NIST (2023). Artificial Intelligence Risk Management Framework (AI RMF 1.0). NIST AI 100-1. DOI 10.6028/NIST.AI.100-1 — https://doi.org/10.6028/NIST.AI.100-1
- Senado Federal. Projeto de Lei nº 2338, de 2023 — https://www25.senado.leg.br/web/atividade/materias/-/materia/157233
- Brasil. Decreto nº 9.013, de 29 de março de 2017 (RIISPOA) — https://www.planalto.gov.br/ccivil_03/_ato2015-2018/2017/decreto/d9013.htm


Deixe um comentário