
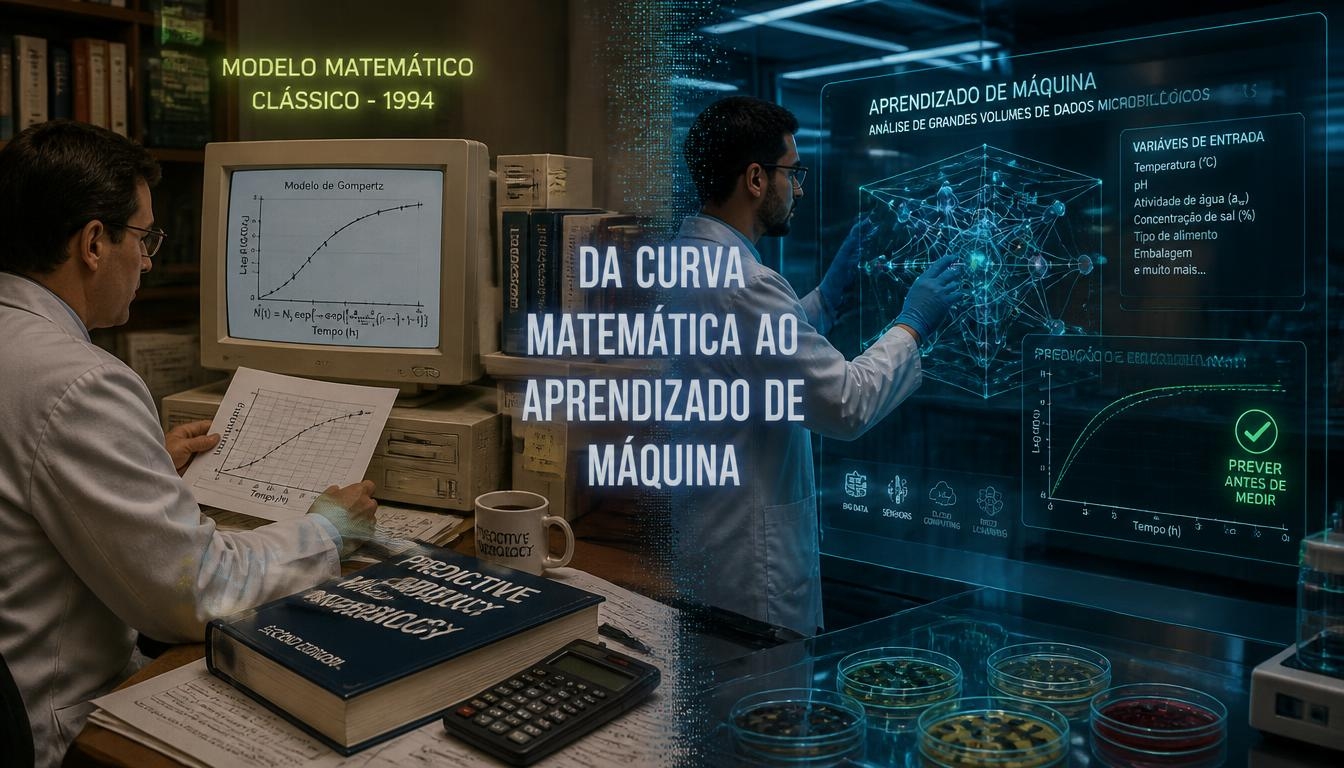
Um caminhão com carne refrigerada fica parado três horas num pátio, a 12 °C, até a câmara voltar a funcionar. O responsável técnico precisa decidir: o lote segue ou não? Ninguém vai esperar o resultado de uma análise microbiológica que leva dias, e o olho humano não enxerga quantas bactérias se multiplicaram nesse intervalo. Existe, porém, uma forma de estimar o que aconteceu com base em temperatura, tempo, pH e atividade de água. Essa é a microbiologia preditiva, e é provavelmente a área da segurança dos alimentos em que a matemática trabalha mais perto da decisão do dia a dia.
É também o terreno onde o aprendizado de máquina está entrando primeiro, com menos barulho e mais consequência do que em muitas das aplicações de inteligência artificial que ganham manchete.
O conceito, em camadas
Para qualquer pessoa. Microbiologia preditiva é usar modelos matemáticos para estimar como uma população de microrganismos vai se comportar num alimento, em determinadas condições. Em vez de perguntar “quantas bactérias tem aqui?”, ela pergunta “quantas vão ter, se eu mantiver este produto nestas condições por este tempo?”. É a diferença entre medir e prever.
Para quem trabalha com inspeção e qualidade. A área organiza seus modelos em três níveis, uma classificação que revisões recentes da literatura ainda usam:
- Modelos primários descrevem a curva de crescimento ou de inativação ao longo do tempo numa condição fixa: fase lag, taxa máxima de crescimento, população máxima. O modelo de Baranyi e Roberts, publicado em 1994, é um dos mais usados; o de Gompertz é outro clássico, e uma revisão de 2024 na International Journal of Microbiology registra sua limitação conhecida, a de descrever mal a fase exponencial e superestimar parâmetros.
- Modelos secundários descrevem como os parâmetros do modelo primário mudam com o ambiente: temperatura, pH, atividade de água, sal, atmosfera, ácidos orgânicos.
- Modelos terciários são o software que junta os dois e entrega uma resposta a quem não vai resolver equações. O ComBase, mantido com apoio do Serviço de Pesquisa Agrícola do Departamento de Agricultura dos Estados Unidos, é o exemplo mais conhecido: reúne um banco de respostas microbianas quantificadas, que o próprio site descreve como mais de 58 mil registros, e ferramentas de predição. Seu módulo de caldo usa, segundo a documentação, o modelo de Baranyi e Roberts como modelo primário e um polinômio quadrático multivariado como modelo secundário.
Os modelos também se distinguem entre cinéticos, que tratam de velocidade de crescimento, e probabilísticos, que tratam da chance de um evento acontecer, como a germinação de um esporo ou a produção de toxina.
Como isso aparece na prática no Brasil
Não existe no Brasil uma norma que obrigue o uso de modelos preditivos, mas eles aparecem, na prática, em três lugares.
No APPCC. O Decreto nº 9.013/2017 (RIISPOA) exige que os estabelecimentos registrados mantenham programas de autocontrole, e o APPCC é um deles. Quando a equipe define um limite crítico de temperatura e tempo, está, implicitamente, apoiada em conhecimento preditivo: alguém mediu, em algum momento, quanto um patógeno cresce naquelas condições. Usar um modelo torna essa base explícita e documentável.
Na validação de processos. Validar é demonstrar que o controle funciona. Para processos térmicos, de fermentação, de secagem ou de acidificação, modelos de inativação e de crescimento permitem justificar tecnicamente por que determinada combinação de parâmetros é suficiente, antes e além dos testes de desafio.
Na avaliação de risco que vira norma. Os padrões microbiológicos aplicáveis a alimentos no Brasil, hoje reunidos na Instrução Normativa Anvisa nº 161/2022, e os documentos do Codex Alimentarius sobre avaliação de risco microbiológico se apoiam em estimativas quantitativas de exposição. Microbiologia preditiva é um dos insumos dessas estimativas.
Erros comuns de entendimento
“O modelo diz que está seguro.” Não é isso que ele diz. Um modelo estima o comportamento provável de uma população microbiana nas condições informadas. Ele não atesta a segurança de um lote, não substitui análise laboratorial e não cobre o que não foi informado. A documentação do ComBase é explícita: “o uso dos modelos de caldo do ComBase não substitui o teste dos produtos antes da liberação”.
“Se vale no laboratório, vale no alimento.” Os modelos de caldo são construídos em meios de cultura, em condições controladas. O alimento real tem estrutura, gordura, microbiota competidora, gradientes de temperatura e embalagem. A documentação do ComBase registra que esses modelos se baseiam apenas em experimentos observados em meios de cultura. Prever num caldo e aplicar num salame sem verificação é um atalho perigoso.
“Se o modelo aceita o número, a resposta é válida.” Esse é o erro mais frequente e o mais fácil de evitar. Modelo empírico não se extrapola. A documentação do ComBase coloca isso como princípio básico: não se deve fazer predições fora da região de observações. Se o modelo foi construído entre 2 °C e 12 °C, uma resposta para 20 °C não é uma resposta; é uma extrapolação.
“Previsão e risco são a mesma coisa.” Perigo, exposição e risco são conceitos distintos. Um modelo de crescimento estima exposição potencial. Transformar isso em risco à saúde exige dose-resposta, consumo e população. Confundir as duas coisas produz conclusões sanitárias que o cálculo não sustenta.
Lente IA: onde o aprendizado de máquina muda o jogo
É aqui que a conversa fica atual. Os modelos clássicos têm uma forma fixa: alguém escolhe a equação e ajusta os parâmetros aos dados. O aprendizado de máquina inverte parte disso, deixando que o algoritmo encontre a relação entre entradas e saída. A revisão de 2024 já citada resume a vantagem em uma frase: algoritmos de aprendizado de máquina são mais flexíveis e dinâmicos que os modelos convencionais de microbiologia preditiva porque não exigem fórmulas rígidas.
Essa flexibilidade é valiosa em três situações concretas:
- Muitas variáveis ao mesmo tempo. Um polinômio de segunda ordem dá conta de três ou quatro fatores. Quando entram sensores de cadeia do frio, dados de composição, histórico de lote e informação de microbiota, a relação é complexa demais para uma forma fixa.
- Dados que não vêm de experimentos planejados. Registros de autocontrole, séries de temperatura de IoT e resultados de rotina são abundantes e desorganizados, exatamente o tipo de material em que esses algoritmos se saem bem e os modelos clássicos não conseguem entrar.
- Sinais indiretos. Espectros, imagens e respostas de sensores de gases não têm equação biológica evidente ligando o sinal à contagem microbiana; é um problema de reconhecimento de padrão.
A contrapartida exige a mesma frieza que o canal aplica a toda tecnologia. A flexibilidade que elimina a fórmula rígida também elimina o significado biológico dos parâmetros: um modelo clássico informa uma taxa de crescimento interpretável, e muitos modelos de aprendizado de máquina informam apenas um número. Isso tem três consequências práticas.
Primeira, o problema da extrapolação não desaparece, piora. Um polinômio avisa quando sai da faixa, porque a faixa está declarada. Um modelo treinado com dados de uma planta, numa faixa de temperatura, pode devolver uma previsão de aparência confiável para uma condição que nunca viu, sem nenhum alerta.
Segunda, a qualidade do dado passa a ser o fator limitante. Sensor descalibrado, registro preenchido por hábito e horário anotado por estimativa produzem um modelo que aprende o erro.
Terceira, validação externa deixa de ser formalidade. Um modelo que acerta nos dados em que foi treinado não provou nada; precisa ser testado em dados de outro período e, de preferência, de outra planta, com desempenho relatado em termos que importam para a decisão, incluindo a taxa de falsos negativos. Em segurança dos alimentos, o erro de dizer “está bom” quando não está é mais caro que o inverso.
Nada disso é motivo para recusar a ferramenta. É motivo para exigir dela a mesma coisa que se exige de um modelo clássico, e que a microbiologia preditiva aprendeu a cobrar em três décadas: faixa de validade declarada, validação independente e consciência de que a previsão informa a decisão, mas não a assina.
Em resumo
- Microbiologia preditiva estima como microrganismos vão se comportar num alimento a partir de condições como tempo, temperatura, pH e atividade de água, organizando-se em modelos primários, secundários e terciários.
- Ferramentas como o ComBase tornam isso acessível, e usam modelos consagrados como o de Baranyi e Roberts; a própria documentação avisa que os modelos de caldo não substituem o teste do produto.
- O erro mais comum e mais evitável é extrapolar: fora da faixa em que o modelo foi construído, a resposta não é previsão.
- O aprendizado de máquina amplia o alcance da área, porque lida com muitas variáveis e com dados de rotina, mas devolve números menos interpretáveis e pode extrapolar sem avisar.
- Previsão não é prova e não é risco: estimar crescimento é estimar exposição; risco à saúde exige dose-resposta, consumo e população.
O algoritmo vê o que foi treinado para ver. O modelo prevê o que foi construído para prever. Em ambos os casos, quem decide continua sendo quem responde.
Leia também no Além do Carimbo: “Alguns graus que mudam tudo: o que 918 curvas de crescimento revelam sobre a Listeria na geladeira” e “O algoritmo também envelhece: o que é a deriva de modelo e por que uma IA validada na inspeção precisa de vigilância contínua”.
Referências
- Baranyi J, Roberts TA (1994). A dynamic approach to predicting bacterial growth in food. International Journal of Food Microbiology 23:277-294. DOI 10.1016/0168-1605(94)90157-0 — https://doi.org/10.1016/0168-1605(94)90157-0
- Taiwo OR et al. (2024). Advancements in Predictive Microbiology: Integrating New Technologies for Efficient Food Safety Models. International Journal of Microbiology 2024:6612162. DOI 10.1155/2024/6612162 — https://pmc.ncbi.nlm.nih.gov/articles/PMC11126350/
- ComBase — ComBase Predictor Help (documentação dos modelos) — https://combase.ars.usda.gov/Predictor_Help.aspx
- ComBase — A Web Resource for Quantitative and Predictive Food Microbiology — https://combase.errc.ars.usda.gov/
- Decreto nº 9.013/2017 (RIISPOA) — https://www.planalto.gov.br/ccivil_03/_ato2015-2018/2017/decreto/d9013.htm
- Anvisa — Instrução Normativa nº 161/2022 — https://www.in.gov.br/en/web/dou/-/instrucao-normativa-in-n-161-de-1-de-julho-de-2022-413366880
- Codex Alimentarius — Principles and guidelines for the conduct of microbiological risk assessment (CXG 30-1999) — https://www.fao.org/fao-who-codexalimentarius/codex-texts/guidelines/en/

Deixe um comentário