
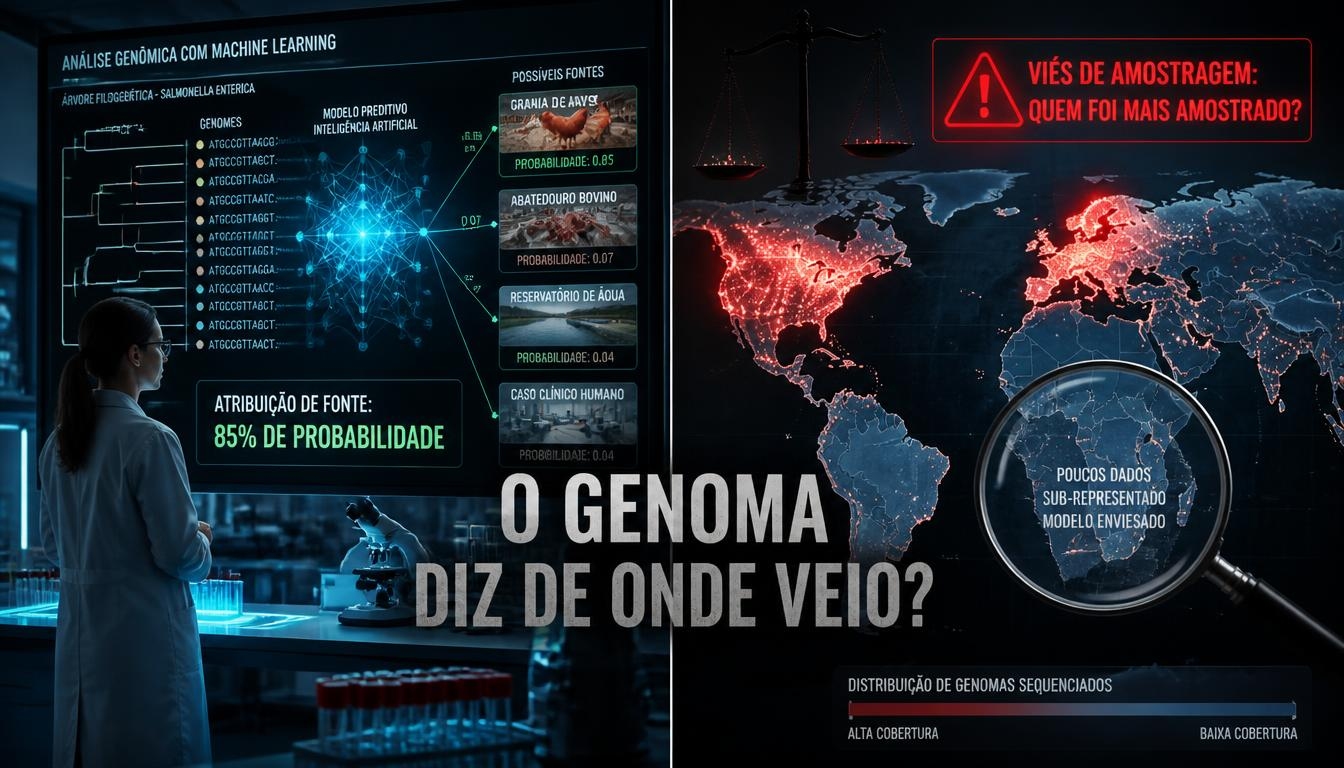
Uma pessoa chega ao hospital com diarreia, febre e cólicas. O laboratório isola uma Salmonella. Não há surto, não há restaurante suspeito, ninguém lembra exatamente o que comeu dez dias antes. Para a saúde pública, porém, aquele caso isolado guarda uma pergunta valiosa: de qual animal, de qual cadeia produtiva, aquela bactéria provavelmente veio? Somados, milhares de casos assim decidem onde o país deve investir em controle: na granja de frangos, na suinocultura, no gado de corte.
Esse esforço tem nome: atribuição de fonte. E é um dos lugares onde a inteligência artificial já trabalha de verdade na segurança dos alimentos, longe das câmeras da linha de abate e das promessas de fornecedores.
O conceito, em duas camadas
Para qualquer pessoa: cada população de bactérias que vive num tipo de animal acumula, ao longo do tempo, pequenas marcas no DNA, como um sotaque. A Salmonella que circula entre suínos tende a carregar combinações genéticas um pouco diferentes da que circula entre aves. Se tivermos uma grande coleção de bactérias de origem conhecida, dá para treinar um programa de computador para reconhecer esses sotaques e, depois, “ouvir” a bactéria do paciente e estimar de onde ela veio.
Para o profissional: os métodos clássicos de atribuição comparavam frequências de subtipos (sorotipos, padrões de PFGE, MLST) entre fontes animais e casos humanos, como no modelo bayesiano de Hald, usado na Dinamarca. Com o sequenciamento do genoma completo (WGS), cada isolado passa a ser descrito por milhares de variáveis: SNPs do genoma central, alelos de cgMLST, presença ou ausência de genes acessórios. É informação demais para os modelos de frequência. Entram então classificadores de aprendizado de máquina supervisionado, como random forest e boosting, que aprendem quais combinações de marcadores melhor separam as fontes.
O que os estudos já mostraram
Nos Estados Unidos, Zhang e colaboradores (2019) treinaram um random forest com 1.473 genomas de Salmonella Typhimurium e 3.137 características genéticas. Entre os isolados de quatro fontes animais (bovinos, aves, suínos e aves silvestres), 829 de 1.041 receberam uma previsão considerada precisa, e 91,6% delas estavam corretas. O modelo atribuiu corretamente sete de oito grandes surtos históricos. Mas, quando aplicado aos casos humanos, só 31,9% puderam ser atribuídos com precisão a uma fonte animal.
Na Dinamarca, Munck e colaboradores (2020) usaram cgMLST e um algoritmo de boosting em Salmonella Typhimurium de 2013 e 2014. O modelo chegou a 92% de acurácia na validação e atribuiu 53,3% dos casos domésticos esporádicos a suínos dinamarqueses. O modelo clássico de Hald, com os mesmos dados, apontava 22%. A diferença mostra que a escolha do método muda a conclusão de política pública. Os próprios autores alertam, contudo, que a amostra pequena impediu validação independente e que a técnica usada para equilibrar os dados pode ter inflado a acurácia.
Para Campylobacter, Arning e colaboradores (2021) compararam o método tradicional, que acertava 64%, com modelos de aprendizado de máquina sobre genomas: com cgMLST, a acurácia subiu para 85%. A base de treino, porém, era dominada por frango: 4.147 de 5.799 genomas. O modelo confundia com frequência ovinos e bovinos, e a acurácia para ovinos foi de 57%.
A Autoridade Europeia para a Segurança dos Alimentos (EFSA), em parecer de 2019 sobre WGS, registrou que a Dinamarca substituiu em 2017 o modelo de Hald por um classificador de aprendizado de máquina baseado em cgMLST. O mesmo parecer lista as fragilidades: amostragem representativa é difícil, algumas fontes nunca são amostradas, genótipos mudam com o tempo e semelhança genética, sozinha, não prova transmissão.
Erros comuns de entendimento
“O algoritmo descobre a origem.” Não exatamente. Ele estima a fonte mais provável entre as fontes que conhece. Se um reservatório nunca foi amostrado, como água, hortaliças ou animais silvestres pouco estudados, o modelo não pode apontá-lo; vai empurrar o caso para a categoria mais parecida. Um estudo europeu de 2025 sobre Campylobacter em vários países lembrou exatamente isso: ausência de atribuição a uma fonte não significa que ela não tenha papel.
“Acurácia de 90% vale para qualquer lugar.” Não vale. Nesse mesmo estudo multinacional, a acurácia dos modelos de cada país variou de 0,51 a 0,96; foi mais baixa onde havia muitas fontes e poucas amostras de cada uma. E as fontes mais amostradas, como o frango, tendem a ser superestimadas. O algoritmo vê o que foi treinado para ver.
“Atribuição de fonte e investigação de surto são a mesma coisa.” São complementares. Na investigação de surto, o genoma confirma se os doentes compartilham a mesma linhagem e se ela bate com um alimento suspeito. Na atribuição, o objetivo é estatístico: estimar a fração de casos que cada cadeia produtiva provoca, para orientar prioridades.
Como isso se aplica ao Brasil
O país participa de redes de vigilância molecular. A PulseNet América Latina e Caribe, coordenada pela Organização Pan-Americana da Saúde, tem como membros brasileiros o Instituto Adolfo Lutz, em São Paulo, e o Instituto Oswaldo Cruz/Fiocruz, no Rio de Janeiro, e está em transição da eletroforese para o sequenciamento genômico. Universidades brasileiras também participam de projetos internacionais que depositam genomas de Salmonella de águas superficiais em bases públicas.
Nenhum dos modelos citados aqui, porém, foi treinado com bactérias brasileiras. Linhagens, sistemas de produção, perfis de exportação e importação são diferentes. Um classificador treinado com Salmonella dinamarquesa ou americana pode simplesmente não reconhecer o “sotaque” das nossas. Para que a atribuição de fonte por IA funcione aqui, é preciso antes um acervo nacional de genomas com origem bem documentada: de granjas, abatedouros, produtos no varejo e casos humanos, amostrados de forma equilibrada e com metadados confiáveis. É a velha regra: dados antes do algoritmo.
Em resumo
- Atribuição de fonte estima de qual cadeia produtiva vêm os casos humanos de uma doença, e orienta onde investir em controle.
- Com o genoma completo, algoritmos de aprendizado de máquina superaram métodos tradicionais em acurácia em estudos com dados dos EUA, da Dinamarca e de bases internacionais de Campylobacter.
- O modelo só reconhece fontes que estão na base de treino; fontes mais amostradas tendem a ser superestimadas.
- Acurácia de laboratório não se transfere automaticamente entre países.
- Para o Brasil, o primeiro passo não é o algoritmo, e sim um banco nacional de genomas representativo.
Referências
- Zhang S, Li S, Gu W, et al. (2019). Zoonotic Source Attribution of Salmonella enterica Serotype Typhimurium Using Genomic Surveillance Data, United States. Emerging Infectious Diseases, 25(1):82–91. DOI 10.3201/eid2501.180835 — https://wwwnc.cdc.gov/eid/article/25/1/18-0835_article
- Munck N, Njage PMK, Leekitcharoenphon P, Litrup E, Hald T (2020). Application of Whole-Genome Sequences and Machine Learning in Source Attribution of Salmonella Typhimurium. Risk Analysis, 40(9):1693–1705. DOI 10.1111/risa.13510 — https://pmc.ncbi.nlm.nih.gov/articles/PMC7540586
- Arning N, Sheppard SK, Bayliss S, Clifton DA, Wilson DJ (2021). Machine learning to predict the source of campylobacteriosis using whole genome data. PLoS Genetics, 17(10):e1009436. DOI 10.1371/journal.pgen.1009436 — https://journals.plos.org/plosgenetics/article?id=10.1371/journal.pgen.1009436
- EFSA BIOHAZ Panel, Koutsoumanis K, et al. (2019). Whole genome sequencing and metagenomics for outbreak investigation, source attribution and risk assessment of food-borne microorganisms. EFSA Journal, 17(12):e05898. DOI 10.2903/j.efsa.2019.5898 — https://pmc.ncbi.nlm.nih.gov/articles/PMC7008917/
- Thystrup C, Brinch ML, Henri C, et al. (2025). Source attribution of human Campylobacter infection: a multi-country model in the European Union. Frontiers in Microbiology, 16:1519189. DOI 10.3389/fmicb.2025.1519189 — https://www.frontiersin.org/journals/microbiology/articles/10.3389/fmicb.2025.1519189/full
- OPAS — Red PulseNet América Latina y el Caribe — https://www.paho.org/es/red-pulsenet-america-latina-caribe-pnalc
- JIFSAN/University of Maryland — Water Project (Latin America) — https://jifsan.umd.edu/research/water_project
Leia também no Além do Carimbo: “Quantas letras de diferença fazem um surto? O que o sequenciamento genômico já resolve na vigilância de DTA?” e “O algoritmo aprende com a sua planilha: por que a qualidade dos registros de autocontrole decide o sucesso da IA na inspeção”.

Deixe um comentário