
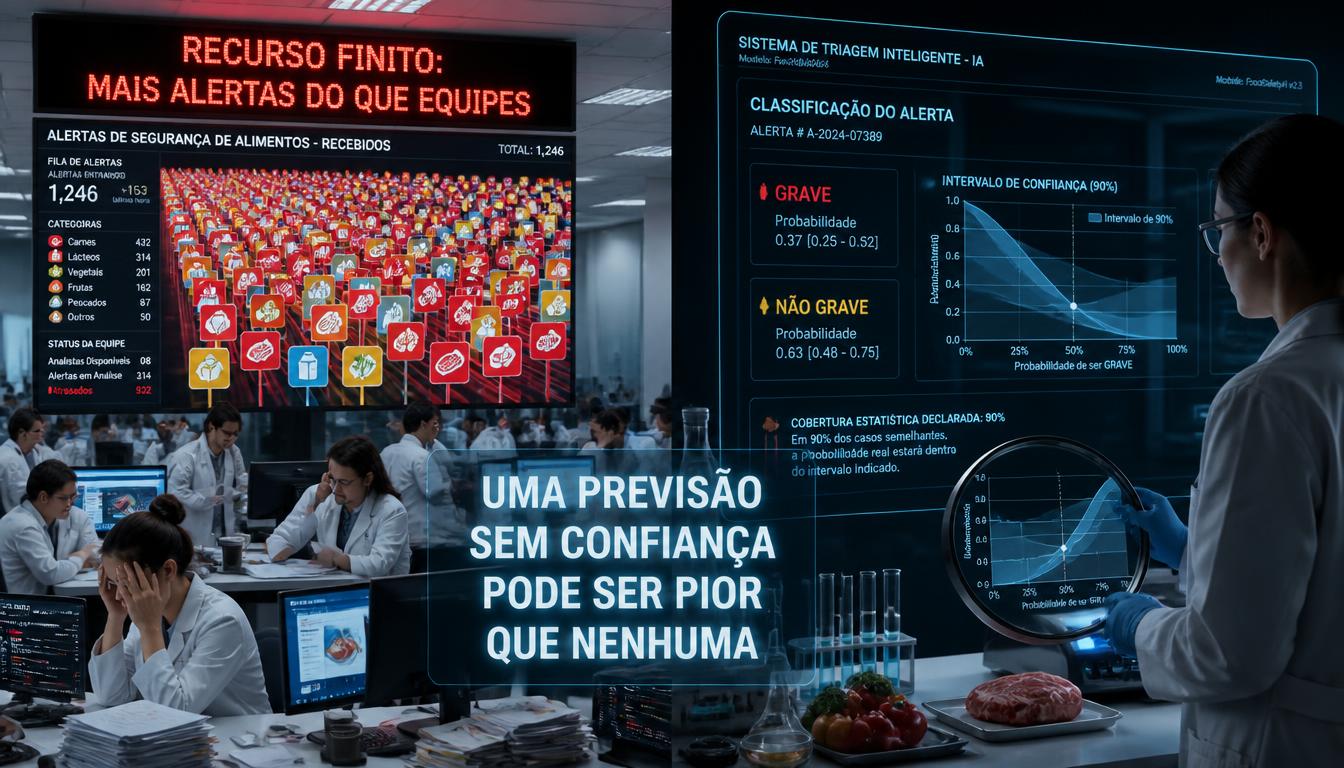
Um estudo de 2026 propõe um framework de machine learning que estima o risco de alertas da União Europeia e informa, junto com cada previsão, o grau de incerteza.
Abertura
Quem trabalha com inspeção sabe que o recurso é finito. Há mais notificações de risco do que equipes para analisar cada uma, e a decisão sobre o que tratar primeiro precisa ser tomada rápido. Modelos de inteligência artificial prometem ajudar nessa triagem, mas uma previsão sem indicação de confiança pode ser pior do que nenhuma, porque transmite certeza onde ela não existe.
Um estudo publicado em setembro de 2026 na revista Frontiers in Food Science and Technology tenta enfrentar exatamente esse problema. Os autores construíram um sistema que classifica alertas de segurança alimentar como graves ou não graves e, o mais importante, entrega para cada caso um conjunto de possibilidades com cobertura estatística declarada.
O que o estudo fez
A base de dados é o RASFF, o sistema europeu de alertas rápidos para alimentos e rações. Os pesquisadores usaram 22.643 notificações de 2019 a 2025, divididas cronologicamente em treino, calibração e teste, para evitar que o modelo “espie” o futuro.
O modelo principal é o XGBoost, um algoritmo de aprendizado de máquina baseado em árvores de decisão. Três componentes foram combinados. O primeiro compensa o desbalanceamento: quase 80% das notificações são classificadas como graves, o que distorce qualquer modelo ingênuo. O segundo corrige as probabilidades, que ficavam excessivamente confiantes. O terceiro, chamado conformal prediction na variante Mondrian, gera conjuntos de previsão com cobertura garantida dentro de cada região geográfica.
O que os números mostram
O modelo atinge acurácia de 78,4%, com kappa de Cohen de 0,296 e coeficiente de Matthews de 0,297. Esses valores de concordância são moderados, e o próprio estudo reconhece isso. A acurácia parece alta em parte porque a maioria dos casos é de risco grave; por isso, os autores destacam métricas que expõem a dificuldade da classe minoritária. A especificidade, isto é, a capacidade de identificar corretamente os casos não graves, foi de 45,7%.
A calibração foi a contribuição mais sólida. Antes da correção, o erro de calibração esperado era de 0,267; depois, caiu para 0,043, uma redução de 84%. Em termos práticos, quando o modelo diz que um alerta tem determinada probabilidade de ser grave, essa probabilidade passa a corresponder melhor à frequência real.
A cobertura global ficou em 90,3%, com conjuntos de previsão de tamanho médio 1,22. Em 78% dos casos, o modelo entregou uma única classe. Essa cobertura é uma propriedade estatística do método, e não significa que o modelo acerta 90% das vezes.
Onde o método falha
Aqui está a parte mais importante para quem pensa em usar esse tipo de ferramenta. Na divisão de teste, a região África ficou com cobertura de 77,6%, abaixo da meta de 90%. Os autores atribuem o resultado ao pequeno número de casos africanos, 232 no teste, e uma análise repetida com 5.000 divisões aleatórias mostrou que a média de cobertura converge para o nível esperado. Ou seja, o problema parece ser de tamanho amostral, mas ele existe e precisa ser tratado antes de qualquer uso em decisões reais.
Os próprios pesquisadores classificam o framework como protótipo de apoio à decisão, que exige validação adicional antes de qualquer uso regulatório. Eles também reconhecem que os dados refletem as práticas de notificação da União Europeia e podem não generalizar para outros sistemas.
E o Brasil?
O RASFF é um sistema europeu, e o modelo não pode ser transportado diretamente para a inspeção brasileira. Os dados, as categorias de risco e a estrutura de notificação são diferentes. Mas a lógica do estudo interessa diretamente ao Brasil por três razões.
A primeira é a priorização de recursos. Qualquer serviço de inspeção precisa decidir onde concentrar esforço. Uma estimativa de probabilidade bem calibrada permite comparar casos de forma mais honesta do que uma nota de risco sem escala definida.
A segunda é a comunicação da incerteza. Um conjunto de possibilidades, em vez de um veredito único, pode orientar uma decisão de maneira mais transparente, desde que o sistema diga claramente quando não sabe.
A terceira é a equidade entre regiões. A análise por região expôs que o modelo pode funcionar bem em algumas áreas e mal em outras, justamente onde há menos dados. Para um país com muitas realidades produtivas, como o Brasil, esse alerta é relevante: um sistema pode parecer confiável na média e falhar sistematicamente em estabelecimentos de regiões com menos histórico.
Conclusão
O estudo não resolve o problema da inspeção com inteligência artificial, e não pretende fazê-lo. O que ele oferece é um exemplo de disciplina: medir a incerteza, corrigir as probabilidades, testar por região e reconhecer as limitações antes de propor uso. Na inspeção, uma ferramenta honesta sobre o que não sabe vale mais do que uma que responde sempre com segurança. A decisão continua sendo humana, e a tecnologia só é útil se ajudar a tomá-la melhor.
Referências
- Radhakrishnan, S.; Vijayarajan, V. “Reliable food safety risk assessment via calibrated Mondrian conformal prediction: a machine learning framework with uncertainty quantification”. Frontiers in Food Science and Technology, v. 6, 2026. https://doi.org/10.3389/frfst.2026.1890831
- Base de dados RASFF Window, Comissão Europeia. https://webgate.ec.europa.eu/rasff-window/screen/search
Deixe um comentário